Spis treści (11)
Czy zdarzyło Ci się, że narzędzie SEO pokazało spadek frazy, a w Google wszystko wyglądało normalnie? A może raport mówił „jesteś poza top 10”, choć klient widział Cię na trzecim miejscu?
Jeśli kiwasz głową, to nie jesteś sam. Dane SERP z narzędzi (wyniki wyszukiwania pobierane przez API) potrafią pokazywać zupełnie inną stronę wyników niż ta, którą widzi człowiek przed komputerem.
Pomyśl o tym tak: wysyłasz do sklepu dwóch kurierów po ten sam towar. Jeden wraca z tym, co zamówiłeś. Drugi przynosi coś z tej samej półki, ale z innej dostawy. I nie mówi Ci o tym.
W tym wpisie pokazuję wyniki mojego testu: 11 źródeł danych, 31 fraz, 3 rundy i prawdziwa przeglądarka jako wzorzec. Mówię, którym dostawcom wierzę, którym nie i jak w 10 minut sprawdzić narzędzie, za które płacisz. Zaczynajmy.
W skrócie
- Ta sama fraza, ta sama minuta, inny top 10. Przy „usługi marketingowe” Chrome pokazał stronę Double Digital na 3. miejscu, pierwsze pobranie z DataForSEO na 4., a dwa kolejne (4 i 9 minut później) w ogóle bez niej w top 10.
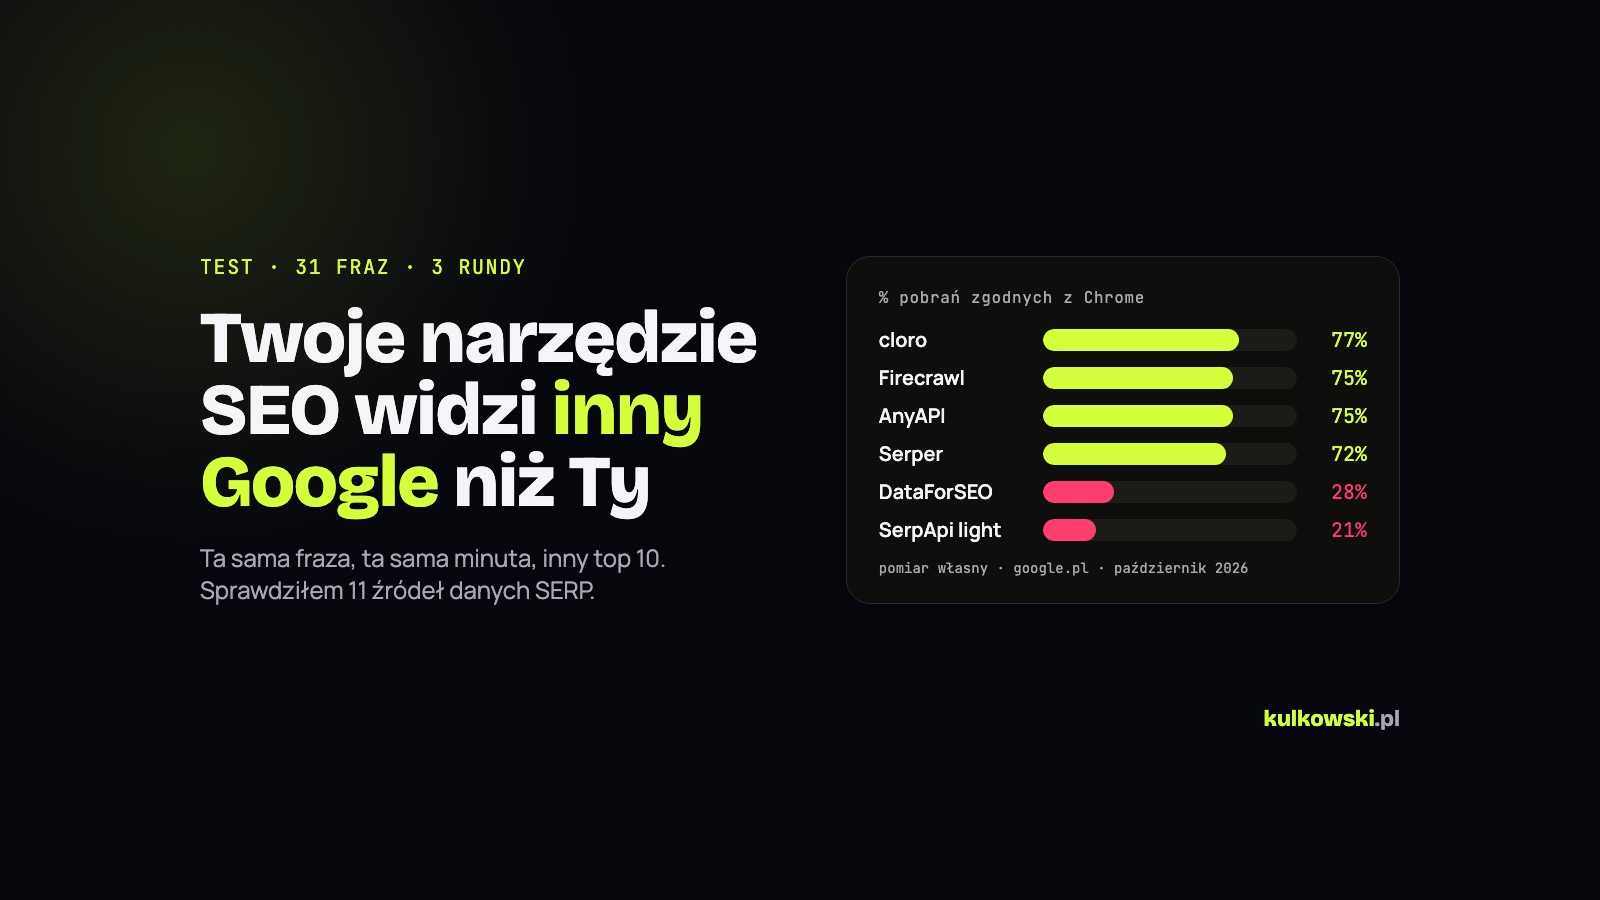
- Najbliżej przeglądarki: cloro (77% pobrań w wersji Chrome w trzech rundach), Firecrawl i AnyAPI (po 75%) oraz Serper (72%).
- Najdalej: DataForSEO (28%, losuje między dwiema wersjami), SerpApi light (21%) i SerpApi full (6%).
- To raczej nie „zatrucie SERP-ów”. Druga wersja wyników jest spójna i na temat. Śmieciowych SERP-ów znalazłem 3 na ok. 1,5 tys. pobrań z dwóch pierwszych rund.
- Wniosek praktyczny: jedno pobranie to rzut monetą. Sprawdzaj frazę kilka razy, a o pozycji własnej strony rozstrzygaj w Search Console.
Co sprawdzałem i jak
Pytanie było proste: czy SERP z narzędzia to ten sam SERP, który widzi człowiek w Polsce? Od tego zależy każda analiza konkurencji, każdy brief treści i każdy raport pozycji.
Wzorcem była zwykła przeglądarka Chrome na komputerze w Warszawie (google.pl, język polski, personalizacja wyłączona parametrem pws=0). Wcześniej sprawdziłem, że okno incognito daje w niej te same wyniki co zalogowane konto.
Testowałem 31 fraz w 8 grupach:
- Lokalne z miastem: np. „dentysta warszawa”, „hydraulik kraków”.
- Lokalne bez miasta: „pizza w pobliżu”, „apteka całodobowa”, „weterynarz”.
- Zakupowe: „iphone 16 pro cena”, „kredyt hipoteczny”.
- Porównawcze: „ranking kont osobistych”, „allegro czy temu”.
- Informacyjne: „ldl cholesterol”, „co to jest seo”.
- Usługi B2B: 4 frazy, na które realnie pokazuje się agencja Double Digital.
- Nawigacyjne: „allegro”, „double digital”.
- Świeże: „kurs euro”.
W tej samej minucie co przeglądarka startowały wszystkie API, a każde pobierało frazę 3 razy co 4 minuty. Zrobiłem 3 rundy: dwie 14 października (rano i wieczorem) i jedną 21 października. Łącznie ponad 2,6 tys. udanych pobrań.
Jak liczyłem zgodność
Porównywałem domeny w top 10 metryką RBO (z ang. rank-biased overlap). Daje wynik od 0 do 1 i mocniej waży górę listy, bo różnica na pierwszym miejscu boli bardziej niż na dziesiątym.
- Wersja Chrome (A): RBO ≥ 0,5, czyli w praktyce te same strony w podobnej kolejności.
- Inna wersja (B): RBO < 0,2, czyli prawie zupełnie inny top 10.
- Pomiędzy: wyniki mieszane.
Najważniejsza obserwacja z metody: przeglądarka jest stabilna. Dwa odczyty Chrome w odstępie 10–25 minut były identyczne we wszystkich 31 frazach. Po tygodniu mediana RBO wciąż wynosiła 0,84. Rozjazd narzędzi nie jest więc „naturalnym ruchem w Google”.
Ten sam Google, ta sama minuta: dwa przykłady
Zacznę od frazy, przy której wynik dotyczy firmy, którą znam od środka. Runda z 21 października, fraza „usługi marketingowe”:
| Źródło i godzina | Top 3 | Double Digital |
|---|---|---|
| Chrome, 21:49 | wenet.pl, maxroy.agency, double-digital.pl | 3. miejsce |
| DataForSEO, 21:49 | wenet.pl, ks.pl, maxroy.agency | 4. miejsce |
| DataForSEO, 21:54 | cyrekdigital.com, ltb.pl, awansujwmarketingu.pl | poza top 10 |
| DataForSEO, 21:58 | cyrekdigital.com, ltb.pl, awansujwmarketingu.pl | poza top 10 |
Dwa z trzech pobrań powiedziałyby właścicielowi firmy, że wypadł z pierwszej strony. W przeglądarce nic się nie stało.
Drugi przykład, fraza „agencja marketingowa gdańsk”, godzina 19:01:
- Chrome: yourewelcome.pl, digitalk.pl, jamel.pl.
- DataForSEO, pobranie 1 (ta sama minuta): humint.pl, oferteo.pl, projectup.pl.
- Pobranie 2 (ok. 5 minut później): yourewelcome.pl, digitalk.pl, getknow.pl, czyli znów wersja Chrome.
- Pobranie 3 (kolejne ok. 5 minut): z powrotem humint.pl i oferteo.pl.
To nie jest jeden pechowy przypadek. W ostatniej rundzie DataForSEO dało obie wersje wyników w 12 z 31 fraz.
Wyniki: które źródło widzi to, co Ty
Tabela pokazuje odsetek pobrań w wersji Chrome (frazy bez lokalizacji miasta). Kolumna „Razem” to wszystkie trzy rundy.
| Źródło | Runda 1 | Runda 2 | Runda 3 | Razem | Koszt 1000 SERP-ów w teście |
|---|---|---|---|---|---|
| cloro | 74% | 77% | 80% | 77% | ok. 2,8 USD |
| Firecrawl | 69% | 75% | 77% | 75% | ok. 10 USD |
| AnyAPI | 75% | 77% | 71% | 75% | ok. 0,5 USD |
| Serper | 75% | 70% | 70% | 72% | ok. 1 USD |
| NodesHub | 64% | 73% | 72% | 69% | — |
| Serpstat (baza) | 62% | 62% | 79% | 68% | ok. 5 USD |
| Ahrefs (baza) | 47% | 50% | — | 49% | — |
| crawl4ai | 20% | 20% | 70%* | 37% | ok. 0,15 USD |
| DataForSEO | 27% | 36% | 22% | 28% | ok. 4 USD |
| SerpApi light | 10% | 47% | 6% | 21% | ok. 15 USD |
| SerpApi full | 6% | — | — | 6% | ok. 15 USD |
* crawl4ai w rundzie 3 pobrałem dzień później niż przeglądarkę (limit dostawcy), więc ten skok czeka na potwierdzenie. Koszty to stawki z mojego testu (część dostawców szła przez pośrednika treg), nie cenniki z ich stron.
Czołówka: cloro, Firecrawl, AnyAPI i Serper
Te cztery źródła dostają wersję przeglądarki w ok. 3 na 4 pobrania. cloro wypadło najlepiej i najrówniej: w ostatniej rundzie ani jednego pobrania z zupełnie innym top 10, a 27 z 31 fraz w tej samej wersji przez wszystkie trzy rundy.
AnyAPI jest najtańsze i długo było najstabilniejsze, ale w rundzie 3 przy 8 frazach przeskakiwało między wersjami. Serper rzadziej trafia idealnie w kolejność, za to prawie nigdy nie pokazuje zupełnie innej strony wyników.
Rzut monetą: DataForSEO
Z DataForSEO korzysta pod spodem wiele narzędzi SEO (np. OpenSEO, którego sam używam), więc ten wynik boli najbardziej. Problem nie polega na tym, że zawsze się myli. Problem polega na tym, że nie wiesz, którą wersję dostałeś.
Jedna rzecz działa tam dobrze: lista źródeł w Google AI Overview. W pilocie zgadzała się z przeglądarką co do domeny, nawet gdy zwykłe wyniki się rozjeżdżały. Więcej o samym mechanizmie AIO piszę w przewodniku czym jest Google AI Overview.
Inny Google: SerpApi
SerpApi w obu wariantach najczęściej pokazywało wersję B. W rundzie 2 wariant light niespodziewanie poprawił się do 47%, ale w rundzie 3 wrócił do 6%. Do porównań z tym, co widzi klient w przeglądarce, tego źródła nie używałbym w ogóle.
Bazy danych: Serpstat i Ahrefs
To inna kategoria: nie pobierają SERP-u na żywo, tylko pokazują zapisany wcześniej stan. Serpstat zgadzał się z przeglądarką w ok. 2 na 3 przypadkach, Ahrefs w co drugim. Do szybkiego rozpoznania tematu wystarczy, do decyzji o pojedynczej frazie już nie.
Gdzie myli się każdy
Frazy lokalne wypadały najsłabiej u wszystkich dostawców. W rundzie 3 z lokalizacją „Warszawa” najlepsze źródło (cloro) trafiało w wersję Chrome w 85% pobrań, DataForSEO w 48%, a SerpApi light w 0%. Najlepiej szło przy frazach nawigacyjnych, takich jak „allegro”: tam większość źródeł zgadzała się w każdym pobraniu.
Czy to zatrucie SERP-ów?
Jesienią 2026 głośno było o zatruwaniu SERP-ów. Nozzle, firma sprzedająca śledzenie pozycji, opisała 10 października w badaniu o zatrutych SERP-ach, że od 20 września Google odsyła części automatycznych zapytań wyniki z podmienionymi stronami. W Polsce dotyczyło to 7,3% z ponad 46 tys. sprawdzonych SERP-ów, a większość epizodów mijała w ciągu 3 dni.
Senuto 14 października opisało podobne zjawisko we wpisie „W marketingu internetowym zamieniamy GPS na kompas”, nazywając je „fake SERP”: wyniki spoza tematu, połączone z frazą jednym słowem albo liczbą. Ich przykład to fraza o skrzynkach na owoce, przy której wypadł rozkład tramwaju nr 20.
Sprawdziłem, ile takich śmieci jest w moich danych z dwóch pierwszych rund. Wynik: 3 wyraźne fake SERP-y na ok. 1,5 tys. pobrań z API, wszystkie od jednego dostawcy (NodesHub). Moja „wersja B” wygląda inaczej. Jest spójna i tematyczna, a ta sama druga wersja powtarza się u kilku dostawców.
Wniosek: większość rozjazdów, które widziałem, to inna, równoległa wersja wyników, a nie podmiana na śmieci. Dlaczego Google ją pokazuje akurat narzędziom, tego z moich danych nie da się rozstrzygnąć.
Mity i błędy w czytaniu danych SERP
Mit 1: „Narzędzie pokazuje pozycję, więc tak jest”
Narzędzie pokazuje pozycję z jednego pobrania. Jeśli dostawca losuje między dwiema wersjami wyników, jeden odczyt mówi tyle samo co rzut monetą.
Mit 2: „Ustawię lokalizację na miasto i problem zniknie”
Lokalizacja pomaga, ale nie rozwiązuje problemu. Frazy lokalne były w moim teście najtrudniejsze dla każdego źródła, także z ustawioną Warszawą.
Mit 3: „Każdy rozjazd to zatrucie, które samo minie”
Zatrucie istnieje, ale to tylko część historii. Niektóre źródła dostają inną wersję wyników systematycznie, tydzień po tygodniu.
Jak sprawdzić swoje narzędzie w 10 minut
Nie musisz powtarzać całego testu. Wystarczy prosta próba na frazach, które znasz.
- Wybierz 3 frazy: jedną lokalną, jedną zakupową i jedną, na którą pokazuje się Twoja strona.
- Sprawdź je w przeglądarce: okno incognito,
google.pl, zapisz top 10. - Pobierz te same frazy z narzędzia 3 razy w odstępie kilku minut.
- Porównaj pierwsze trzy wyniki. Jeśli choć jedno pobranie ma zupełnie inne strony, Twoje narzędzie losuje.
- Pozycję własnej strony potwierdź w Google Search Console. To jedyne źródło liczone z prawdziwych wyświetleń, którego problem pobierania nie dotyczy.
Jeśli chcesz zbudować własny przepływ na API zamiast gotowego narzędzia, zrobimy to razem krok po kroku w moim kursie SEO w 2027 z Claude Code. Porównanie danych z Senuto i treg przy planowaniu strony znajdziesz z kolei w artykule o planie strony pod Google.
Jak pobrać SERP z cloro przez treg
Z cloro, które wypadło w teście najlepiej, korzystałem przez treg. To katalog API z płatnością za wywołanie: nie zakładasz osobnych kont u każdego dostawcy i nie trzymasz ich kluczy u siebie. Uczciwie: to mój link polecający.
- Załóż konto i doładuj saldo. Płacisz za każde pobranie. W moim teście SERP z cloro kosztował ok. 0,0028 USD, czyli ok. 2,8 USD za 1000 fraz.
- Podłącz treg tam, gdzie pracujesz: jako serwer MCP w Claude Code albo jako narzędzie w terminalu (
treg login). - Pobierz wyniki dla frazy. W terminalu wygląda to tak:
treg call cloro.google.serp.organic --method POST \
--data '{"query": "usługi marketingowe", "gl": "PL", "hl": "pl", "device": "desktop", "pages": 1}'- Przy frazach lokalnych dopisz w danych
"location": "Warsaw, Poland"(albo swoje miasto). Jeśli chcesz też źródła z Google AI Overview, dodaj"include": {"aioverview": true}. - Powtórz pobranie 2–3 razy w odstępie kilku minut i porównaj top 3, tak jak w teście.
Z Claude Code wystarczy poprosić zwykłym językiem, np.: „Pobierz przez treg z cloro wyniki Google dla frazy »usługi marketingowe« (Polska, komputer) 3 razy co 4 minuty i porównaj top 10 domen”.
Checklista zaufania do danych SERP
Checklista przed decyzją na danych z narzędzia:
- Czy sprawdziłem frazę więcej niż jednym pobraniem?
- Czy porównałem top 3 z przeglądarką chociaż raz?
- Czy przy frazie lokalnej ustawiłem miasto?
- Czy spadek pozycji potwierdza Search Console?
- Czy wiem, z jakiego dostawcy danych korzysta moje narzędzie?
Ograniczenia testu
Uczciwie: to pomiar jednej osoby, nie badanie rynku. Jeden adres IP w Warszawie, tylko komputer (bez telefonu), 31 fraz i październik 2026, czyli okres tuż po szczycie zatruwania SERP-ów według Nozzle.
Część pobrań powtarzałem z opóźnieniem, bo dostawca odrzucił zapytania albo komputer przeszedł w uśpienie. Opisałem to w raportach z każdej rundy. Wyniki pokazują kierunek, nie gwarancję, że Twoje narzędzie zachowa się identycznie jutro.
Podsumowanie i wnioski
- Narzędzie SEO nie zawsze widzi ten sam Google co Ty. Ta sama fraza w tej samej minucie potrafi dać zupełnie inny top 10.
- Najbliżej przeglądarki były cloro, Firecrawl, AnyAPI i Serper, w ok. 3 na 4 pobrania.
- DataForSEO i SerpApi nie nadają się do pojedynczych odczytów. Pierwsze losuje, drugie zwykle pokazuje inną wersję.
- Frazy lokalne to najsłabszy punkt każdego źródła.
- To w większości nie są śmieciowe SERP-y, tylko spójna druga wersja wyników.
- O pozycji własnej strony rozstrzyga Search Console, a nie pojedynczy odczyt z narzędzia.
Pełne dane dla dociekliwych
Ta część jest dla osób, które chcą sprawdzić moje wnioski albo policzyć coś po swojemu. Wynik każdego z 2648 udanych pobrań (runda, fraza, źródło, lokalizacja, RBO do Chrome, wersja A, B albo mix) jest w pliku dane-test-serp.csv.
Metoda w szczegółach
- Wzorzec: Chrome zalogowany,
google.pl, parametryhl=pl&gl=pl&pws=0, IP w Warszawie, wyniki w wersji na komputer (bez telefonu). Okno incognito dało te same wyniki (RBO 0,94–1,0), więc konto nie zmieniało wyników. - Synchronizacja: zapis wyników z Chrome uruchamiał w tej samej chwili pobrania ze wszystkich API. Każde API pobierało frazę 3 razy, co 4 minuty.
- Rundy: R1 14.10, 12:14–13:45 (Chrome 2 razy, podłoga szumu), R2 14.10, 20:22–22:31, R3 21.10, 18:55–21:56.
- Metryka: RBO z parametrem p = 0,9 liczone na domenach z top 10 wyników organicznych. Wersja A to RBO ≥ 0,5, wersja B to RBO < 0,2.
- Lokalizacja: frazy lokalne pobierałem dodatkowo z lokalizacją „Warszawa” u dostawców, którzy na to pozwalają (cloro, Serper, DataForSEO, SerpApi).
- Bazy (Serpstat, Ahrefs): jeden odczyt na frazę, bo to zapisany stan, a nie pobranie na żywo.
Zgodność według typu frazy (3 rundy razem)
Odsetek pobrań w wersji Chrome. Grupy: A lokalne z miastem, B lokalne bez miasta, C zakupowe, D porównawcze, E informacyjne, F usługi B2B, G nawigacyjne, H świeże („kurs euro”).
| Źródło | A | B | C | D | E | F | G | H |
|---|---|---|---|---|---|---|---|---|
| cloro | 67% | 64% | 98% | 72% | 85% | 53% | 100% | 100% |
| Firecrawl | 67% | 50% | 100% | 78% | 85% | 50% | 100% | 100% |
| AnyAPI | 62% | 61% | 93% | 69% | 87% | 47% | 100% | 100% |
| Serper | 60% | 64% | 78% | 81% | 74% | 53% | 100% | 100% |
| NodesHub | 52% | 42% | 91% | 65% | 88% | 41% | 100% | 89% |
| Serpstat (baza) | 53% | 33% | 87% | 100% | 87% | 25% | 100% | 100% |
| Ahrefs (baza) | 44% | 25% | 60% | 67% | 50% | — | — | — |
| crawl4ai | 36% | 25% | 40% | 33% | 30% | 31% | 83% | 67% |
| DataForSEO | 28% | 17% | 27% | 25% | 20% | 19% | 89% | 56% |
| SerpApi light | 18% | 17% | 20% | 8% | 22% | 8% | 83% | 33% |
| SerpApi full | 0% | 0% | 0% | 0% | 0% | 0% | 100% | 0% |
Najtrudniejsze dla wszystkich są frazy lokalne (A, B) i usługi B2B (F). Przy frazach zakupowych (C) i informacyjnych (E) czołówka trafia w wersję Chrome w 74–100% pobrań.
Stabilność: czy źródło przeskakuje między wersjami
„Przeskakuje” znaczy, że w trzech pobraniach tej samej frazy w jednej rundzie pojawiła się i wersja A, i wersja B. Ostatnia kolumna mówi, w ilu frazach wersja większościowa była taka sama we wszystkich trzech rundach.
| Źródło | Przeskakuje R1 | R2 | R3 | Ta sama wersja w 3 rundach |
|---|---|---|---|---|
| cloro | 1/31 | 1/31 | 0/31 | 27/31 |
| Firecrawl | 0/12 | 0/17 | 0/31 | 15/18 |
| AnyAPI | 3/31 | 0/31 | 8/31 | 26/31 |
| Serper | 0/31 | 0/31 | 0/31 | 25/31 |
| NodesHub | 8/30 | 5/31 | 2/20 | 19/25 |
| crawl4ai | 6/31 | 11/30 | 5/31 | 3/31 |
| DataForSEO | 9/31 | 15/31 | 12/31 | 11/31 |
| SerpApi light | 0/31 | 1/31 | 0/31 | 9/31 |
SerpApi light prawie nie przeskakuje w obrębie rundy, ale między rundami zmienia wersję w większości fraz. Dostaje więc „swoją” wersję wyników, zależnie od dnia i pory. DataForSEO losuje w każdej rundzie.
Lokalizacja „Warszawa” (frazy lokalne)
| Źródło | R1 | R2 | R3 |
|---|---|---|---|
| cloro | 67% | 70% | 85% |
| Serper | 59% | 59% | 67% |
| DataForSEO | 22% | 32% | 48% |
| SerpApi light | 0% | 41% | 0% |
Ustawienie miasta pomaga, ale nie zmienia czołówki: cloro jest najlepsze zarówno bez lokalizacji, jak i z nią.
Co poszło nie tak w trakcie testu
- Firecrawl i Ahrefs w R1–R2 szły przez pośrednika, któremu skończyły się środki. Część fraz uzupełniłem później, części brakuje (stąd mniejsze liczby fraz w tabeli stabilności). W R3 Firecrawl szedł bezpośrednio, a Ahrefs pominąłem.
- SerpApi full zmierzyłem tylko w R1. Wynik 6% był na tyle jednoznaczny, że w kolejnych rundach zostawiłem tylko wariant light.
- Uśpienie komputera w R2 i R3 rozciągnęło kilka fraz. Część pobrań skończyła się błędem i powtórzyłem je 1–3 godziny po odczycie Chrome.
- crawl4ai w R3 odrzucił zapytania z powodu dziennego limitu dostawcy. Wszystkie pobrania z tej rundy są z następnego dnia, ok. 16,5 godziny po Chrome.
- NodesHub zwracał błędy przekroczenia czasu w ok. 1/3 pobrań w R3. Traktuję to jako wynik, nie powtarzałem.
- Chrome dwa razy odczytał pustą stronę wyników. Obie frazy odczytałem ponownie po kilku sekundach i po przeładowaniu.
Najczęściej zadawane pytania
Dlaczego narzędzie SEO pokazuje inne wyniki niż Google w przeglądarce?
Bo pobiera wyniki inną drogą: z innego adresu, innej lokalizacji i jako automat. Google potrafi w takiej sytuacji pokazać inną wersję strony wyników. W moim teście u części dostawców działo się to w większości pobrań.
Które API do wyników Google jest najdokładniejsze?
W moim teście najbliżej przeglądarki były cloro (77% pobrań zgodnych z Chrome), Firecrawl i AnyAPI (po 75%) oraz Serper (72%). To wynik dla polskich fraz, komputera i października 2026.
Czy DataForSEO podaje błędne pozycje?
Nie zawsze błędne, ale niepewne. W 12 z 31 fraz trzy pobrania w ciągu 10 minut dały dwie różne wersje wyników. Pojedynczy odczyt warto więc powtórzyć albo sprawdzić w przeglądarce.
Czym jest zatrucie SERP-ów?
To podmiana wyników, którą Google pokazuje części automatycznych zapytań. Według Nozzle dotyczyła w Polsce 7,3% SERP-ów jesienią 2026. W moich danych śmieciowe wyniki pojawiły się rzadko, częściej widziałem spójną drugą wersję wyników.
Jak sprawdzić, czy moje narzędzie SEO widzi prawdziwy Google?
Wybierz 3 frazy, sprawdź je w przeglądarce incognito i pobierz je z narzędzia 3 razy. Jeśli top 3 się rozjeżdża, nie podejmuj decyzji na pojedynczym odczycie. Pozycję własnej strony potwierdzaj w Search Console.