Spis treści (11)
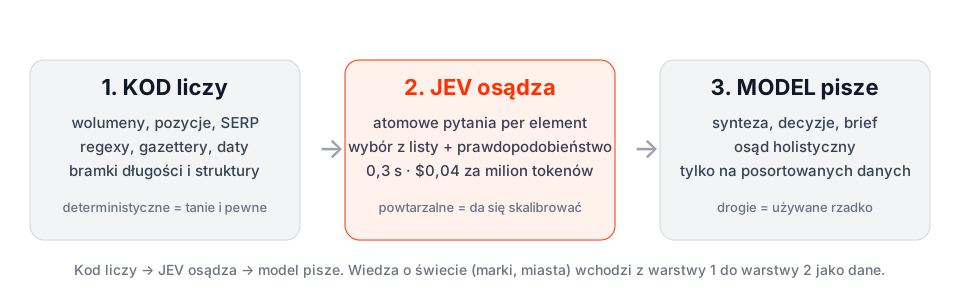
TL;DR: JEV to model AI od TypeSafe (dostępny przez OpenRouter), który nie generuje tekstu. Dostaje fragment treści i typowane pytanie, a oddaje wybór z Twojej listy i prawdopodobieństwo. Przez dwa dni przepuściłem przez niego moje własne dane SEO: sklasyfikował 400 fraz z Search Console za 2,6 centa, w klastrach słów kluczowych wskazał dokładnie tę parę, którą wcześniej oznaczył SERP, w teście na kłamcę ani razu nie uznał cudzego cytatu za dowód, a przy podmienionej liczbie złapał 67 z 80 podmian. Jednocześnie uznał baner cookie za wstęp artykułu, „Stalową Wolę” za markę, a podmienionego roku nie zauważył w 74 przypadkach na 79. Wniosek z całości mieści się w jednym zdaniu: kod liczy, JEV osądza, model pisze — i tylko w tej kolejności to działa.
Wszystkie testy w tym artykule kosztowały łącznie około 20 centów po stronie JEV. Porównawcze przebiegi dwóch „normalnych” modeli językowych na tych samych 120 frazach kosztowały 15 centów — czyli więcej niż wszystko, co JEV zrobił przez dwa dni.
Czym jest JEV i dlaczego „model, który nie pisze” to nie jest wada
JEV to model decyzyjny, nie językowy. TypeSafe nazywa tę klasę „System One” (od Kahnemana: szybkie, wzorcowe osądy zamiast wieloetapowego rozumowania). Wejściem jest tekst plus pytanie o ustalonym typie. Wyjściem nie jest proza, tylko decyzja z rozkładem prawdopodobieństw.
Dostępny jest przez OpenRouter pod identyfikatorem typesafe/jev-1.13 (alias ~typesafe/jev-latest), od 18 września 2026. Wagi są zamknięte, papieru nie ma, jeden hostowany model. Cena: $0,042 za milion tokenów wejścia, wyjście darmowe. Kontekst 32 tysiące tokenów.
Trzy rodzaje pytań, które można mu zadać:
| Prymityw | Co robi | Co zwraca |
|---|---|---|
| Choice | wybiera jedną opcję z listy (do 255 opcji), każdą z opisem | wybraną opcję, prawdopodobieństwo każdej opcji, confidence 0–1 |
| Noul | odpowiada tak/nie na pytanie z opisem obu stron | jedną liczbę 0–1 (prawdopodobieństwo „tak”) |
| Score | ocenia na uporządkowanej skali 2–10 poziomów, każdy z opisem | ważoną wartość, rozkład po poziomach, confidence |
Kilka pytań można zadać w jednym wywołaniu; model odpowiada na nie równolegle i niezależnie. Tak wygląda prawdziwa odpowiedź z mojego pierwszego testu — fragment strony konkurenta zatytułowany „Dlaczego warto współpracować ze mną?” i pytanie o rolę tej sekcji:
{
  "model": "typesafe/jev-1.13-20260917",
  "answers": {
    "role": {
      "type": "choice",
      "choice": "promo_cta",
      "probabilities": {"merytoryczna": 0, "promo_cta": 1, "nawigacja": 0, "autor_komentarze": 0, "none": 0},
      "confidence": 1
    },
    "on_topic": {"type": "noul", "noul": 0.28}
  },
  "usage": {"input_tokens": 661, "output_tokens": 88, "cost": 2.7762e-05}
}
Zwróć uwagę, czego tu nie ma: uzasadnienia, streszczenia, rady, „mam nadzieję, że pomogłem”. Jest decyzja, liczba i koszt: niecałe trzy tysięczne centa.
Dlaczego to ma znaczenie w SEO? Bo znaczna część naszej roboty to nie pisanie, tylko powtarzalne osądy na tysiącach wierszy: czy ta fraza jest komercyjna, czy te dwa zapytania to ta sama potrzeba, czy ta sekcja odpowiada na nagłówek, czy ten cytat wspiera tę liczbę, czy ten fragment strony to treść czy menu. Dziś robimy to albo ręcznie w arkuszu, albo wrzucając wszystko do czatu, który za każdym razem odpowiada inaczej i za każdym razem drożej.
Czat odpowiada na pytanie, które miałeś na myśli. JEV odpowiada na pytanie, które napisałeś. To brzmi jak wada — i w połowie testów poniżej nią jest. W drugiej połowie to jest dokładnie ta cecha, dzięki której wynik da się skalibrować, powtórzyć i podważyć.
Jak testowałem (metodologia bez wchodzenia w szczegóły)
Zasada była jedna: żadnych danych demonstracyjnych. Wszystko, co poniżej, to prawdziwe dane z mojej pracy w Double Digital:
- Search Console — 12 606 fraz z ostatnich 28 dni, z których wziąłem 400 z największą liczbą wyświetleń.
- Klastry słów kluczowych — 100 fraz wokół „agencja seo”, pogrupowane wcześniej embeddingami (k-means), z gotową walidacją SERP-em: dla każdej pary klastrów policzone nakładanie top10 z NodesHub. To jest sędzia — nie ja i nie model.
- Fakty z briefów — 179 twierdzeń liczbowych z naszych briefów treści, każde z cytatem ze źródła.
- Własne strony — 106 podstron double-digital.pl (blog, usługi, słownik, strony miejskie, case studies, Akademia SEO), zcrawlowane Crawl4AI.
- Strony konkurentów — 5 stron z top10 na frazę „reklama warsztatu samochodowego”, po pruningu Crawl4AI.
Każde zadanie rozbiłem na pytania atomowe (jedno pytanie = jedna decyzja, zawsze z opcją „żadne z powyższych”), każdy element (fraza, para fraz, sekcja, twierdzenie) szedł w osobnym wywołaniu z małym state, a agregację (max, średnia, zliczanie) robił kod, nie model. Kryteria pisałem po polsku. Tam, gdzie się dało, porównywałem wynik z niezależnym sędzią: SERP-em, moją własną lekturą, kontrolą negatywną (przetasowane albo podmienione dane) albo drugim modelem.
Progi (np. „etykieta pewna od 0,85”) traktuj jako punkt startowy. Sam TypeSafe pisze, że próg bierze się z własnych etykiet, nie z dokumentacji, i ma rację: w jednym z testów ten sam próg 0,7 działał świetnie dla jednego pytania i beznadziejnie dla innego.
Wersja modelu we wszystkich przebiegach: typesafe/jev-1.13-20260917. Piszę to nie dla pedanterii — alias jev-latest przesuwa się bez ostrzeżenia, a kalibracja progów jest ważna tylko dla konkretnej wersji.
Test 1: 400 fraz z Search Console za 2,6 centa
Zadanie: dla każdej z 400 fraz odpowiedzieć na siedem pytań naraz: intencja (informacyjna / komercyjna / transakcyjna / nawigacyjna), etap lejka (skala 0–2), najbliższa usługa w naszej ofercie (osiem opcji plus „żadna”), szablon zapytania (koszt/cennik, jak zrobić, co to jest, ranking, usługa+miasto, narzędzie, porównanie, samo hasło), czy fraza zawiera markę, czy dotyczy naszej marki, i czy brzmi jak pytanie zadane asystentowi AI.
Wynik: 400 wywołań, 611 tysięcy tokenów wejścia, $0,026, mediana czasu odpowiedzi 0,37 s przy ośmiu równoległych wątkach. Cała próbka w niecałą minutę.
Co z tego wyszło (a czego nie wiedziałem, patrząc na te frazy w GSC):
| Wymiar | Rozkład na 400 frazach |
|---|---|
| Intencja | komercyjna 190 · informacyjna 180 · nawigacyjna 22 · nie do oceny 8 |
| Usługa | pozycjonowanie 138 · Google Ads 86 · pojęcia słownikowe 64 · Meta Ads 52 · agencja lokalna 29 · widoczność w AI 10 · narzędzia 2 · poza ofertą 19 |
| Wyświetlenia wg usługi | pozycjonowanie 34,5 tys. · Meta Ads 17,3 tys. · słownik 15,4 tys. · Google Ads 15,4 tys. · widoczność w AI 5,6 tys. · agencja lokalna 5,0 tys. |
| Szablon zapytania | samo hasło 240 · usługa+miasto 97 · koszt/cennik 32 · ranking 9 · co to jest 9 · narzędzie 5 · jak zrobić 4 |
| „Brzmi jak pytanie do AI” (≥0,7) | 10 fraz, m.in. „ile kosztuje reklama na instagramie”, „jak analizować ekspozycję marki w modelach ai” i jedno pełne zdanie wklejone z promptu |
Najbardziej użyteczna nie była żadna z etykiet, tylko pasmo niepewności: 84 frazy (21%) dostały etykietę usługi z pewnością poniżej 0,6. „Moje opinie google”, „agencja sem”, „crawler”, „deep search”. To nie są błędy modelu — to lista fraz, które faktycznie nie pasują czysto do żadnej z moich ośmiu szufladek. Czat dałby mi 400 pewnych siebie etykiet. JEV dał mi 316 pewnych i 84 do przejrzenia. Wolę to drugie.
Ta sama robota w Claude Haiku 4.5 i GPT-4.1 mini
Żeby nie porównywać JEV z niczym, puściłem 120 z tych fraz przez dwa tanie modele językowe z wymuszonym JSON-em, z tą samą listą kategorii i tym samym kontekstem o naszej marce.
| JEV | GPT-4.1 mini | Claude Haiku 4.5 | |
|---|---|---|---|
| Koszt na 1 000 fraz | ~$0,06 | $0,28 | $0,93 |
| Mediana czasu odpowiedzi | 0,31 s | 0,89 s | 1,33 s |
| Zgodność z JEV: intencja | — | 77% | 78% |
| Zgodność z JEV: szablon zapytania | — | 83% | 78% |
| Zgodność z JEV: marka (tak/nie) | — | 85% | 88% |
| Zgodność z JEV: usługa | — | 56% | 50% |
| Zgodność obu LLM-ów między sobą: intencja / szablon / usługa | 91% / 90% / 82% |
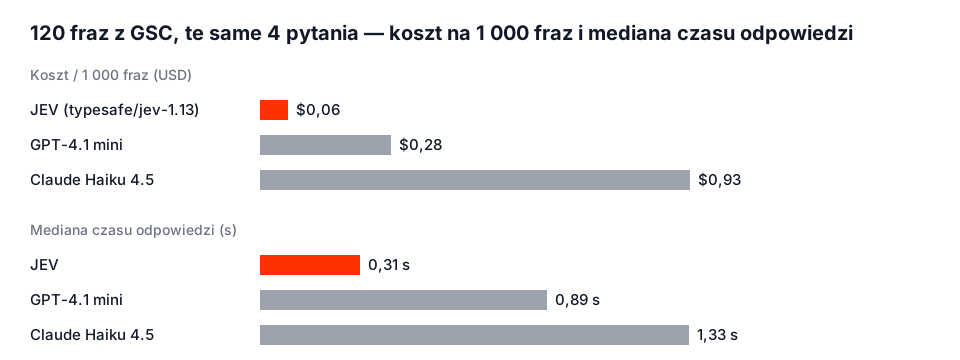
Na intencji, szablonie i marce trzy modele zgadzają się mniej więcej tak samo często, jak dwa LLM-y zgadzają się ze sobą — czyli to poziom naturalnej niejednoznaczności tych etykiet, nie słabość JEV. Ciekawe jest pole usługa, gdzie JEV odstaje od obu LLM-ów. Z 44 rozbieżności 21 to ten sam przypadek: fraza typu „pozycjonowanie tychy”. Oba LLM-y przypisały ją do „agencja marketingowa w konkretnym mieście”, JEV do „pozycjonowanie / SEO”.
Kto ma rację? Moje kryteria były nakładające się — fraza z miastem pasuje do obu opisów. LLM-y rozstrzygnęły to wiedzą o świecie („to zapytanie lokalne”), JEV wziął dosłownie pierwszy pasujący opis. Dla mojej strony JEV trafił lepiej, bo „pozycjonowanie {miasto}” prowadzi u nas do podstron /uslugi/pozycjonowanie/{miasto}/, nie do stron agencyjnych. Ale to szczęście, nie zasługa. Lekcja: kategorie dla JEV muszą być rozłączne, a jeśli nie mogą być, rozbij pytanie na dwa („czy jest miasto?” i „która usługa?”) i złóż w kodzie.
Test 2: klastry słów kluczowych — czy JEV widzi to, co widzi SERP?
To był test, którego najbardziej się bałem, bo tu mam prawdziwego sędziego. Sto fraz wokół „agencja seo” miałem już pogrupowane embeddingami w 17 klastrów, a dla każdej pary klastrów policzone nakładanie top10 Google. Walidator SERP oznaczył jedną parę do przeglądu (nakładanie 50%): „pozycjonowanie stron katowice” i „pozycjonowanie katowice”. Pozostałe 135 par miało nakładanie 0%.
Pytanie do JEV: dla każdej pary kanonicznych zapytań — czy wyrażają tę samą potrzebę i powinny prowadzić do tej samej strony (tak/nie), plus relacja (identyczne / ta sama usługa inne miasto / ten sam temat inny etap / ogólne vs lokalne / niepowiązane).
Wynik: JEV dał 0,85 dokładnie tej jednej parze, którą oznaczył SERP, z relacją „identyczne”. Wszystkie pozostałe 135 par dostało 0,20–0,33. Zero fałszywych alarmów, zero przeoczeń.
Potem odwróciłem zadanie: każdą ze 100 fraz kazałem przypisać do jednego z 17 klastrów (opisanych zapytaniem kanonicznym) albo do „żadnego”. Zgodność z embeddingami: 79%. Ale najciekawsze były te 21 rozbieżności:
| Fraza | Embedding (k-means) | JEV | Kto ma rację |
|---|---|---|---|
| pozycjonowanie gdańsk | klaster „pozycjonowanie katowice” | żaden (0,50) | JEV — nie ma klastra dla Gdańska, embedding wcisnął frazę do najbliższego miasta |
| pozycjonowanie stron internetowych toruń | klaster „pozycjonowanie bydgoszcz” | żaden | JEV, ten sam błąd |
| ile kosztuje seo | klaster „ranking firm seo” | „pozycjonowanie stron ceny” (0,98) | JEV, oczywiste |
| ranking agencji seo | klaster „agencja seo” | „ranking firm seo w polsce” (0,99) | JEV |
| agencja seo warszawa | klaster „pozycjonowanie stron warszawa” | „agencja seo” (0,49) | nie wiadomo — i JEV to wie |
Ostatni wiersz jest dla mnie najważniejszy. Embedding grupuje po tokenach: „agencja seo warszawa” i „pozycjonowanie stron warszawa” dzielą miasto, więc lądują razem. JEV pyta o potrzebę i widzi dwie możliwości — stąd pewność 0,49–0,59 dla całej tej rodziny fraz. To jest prawdziwa niejednoznaczność, którą rozstrzyga tylko Google: czy na tę frazę pokazuje strony miejskie, czy ogólne strony agencji. Model, który przy takiej frazie odpowiada z pewnością 0,5, jest uczciwszy niż model, który odpowiada z pewnością 1,0.
Dwa dodatki, które warto znać, bo pochodzą z większego, równoległego testu, który zrobiliśmy tego samego dnia na 4 950 parach fraz z tego korpusu (wzorcem było nakładanie top10):
- Klasteryzacja zbudowana na osądach JEV (z opisanymi kryteriami, average linkage) dała F1 0,93–0,95 stabilnie dla progu od 0,4 do 0,7, wobec 0,82 dla k-means na embeddingach. Ten sam JEV bez opisanych kryteriów był bezużyteczny — 1 492 fałszywe scalenia. Kryteria to nie dodatek, to całe zadanie.
- JEV nie zna formatu SERP: „firmy seo” (Google pokazuje rankingi) i „agencja seo” (Google pokazuje strony agencji) uznaje za to samo. I nie oszczędza pieniędzy na walidacji: koszt SERP-a liczy się per fraza, a niepewne pary dotykają prawie wszystkich fraz. JEV daje lepszą hipotezę klastrów przed walidacją, nie tańszą walidację.
Powtarzalność: te same 136 par puściłem dzień później. Maksymalna różnica prawdopodobieństwa: 0,04, średnia 0,009. Przypisanie fraz do klastrów: 95 na 100 identycznych. To jest poziom powtarzalności, o którym przy czacie można zapomnieć.
Test 3: kłamca. Czy JEV sprawdzi, że cytat naprawdę wspiera liczbę?
W naszych briefach każda liczba ma metrykę, wartość, okres, rynek i dosłowny cytat ze źródła. Zebrałem 179 takich twierdzeń. Pytanie do JEV, jedno, z wzorca „citation check” z dokumentacji TypeSafe:
{
  "relation": {
    "type": "choice",
    "instructions": "Jak fragment źródła `quote` odnosi się do twierdzenia `claim`?",
    "criteria": {
      "supports": "Fragment stwierdza to twierdzenie lub wprost z niego wynika ta sama wartość/metryka",
      "contradicts": "Fragment podaje inną wartość, inny okres lub przeczy twierdzeniu",
      "says_nothing": "Fragment nie dotyczy tej metryki/wartości"
    }
  }
}
Runda 1 (dzień pierwszy): przetasowane cytaty. 70 prawdziwych par plus 70 par, w których każde twierdzenie dostało cudzy cytat.
| Zestaw | supports | contradicts | says_nothing |
|---|---|---|---|
| prawdziwe pary (70) | 70 | 0 | 0 |
| przetasowane (70) | 0 | 2 | 68 |
Zero fałszywych „wspiera”. Ale to było łatwe zadanie — cudzy cytat zwykle jest o czymś zupełnie innym.
Runda 2 (dzień drugi): podmienione wartości i lata. 80 prawdziwych par; w każdej podmieniłem liczbę (mnożąc przez 1,5, a duże wartości przez 0,5) albo cofnąłem rok w okresie o trzy lata, zostawiając ten sam cytat.
| Zestaw | supports | contradicts | says_nothing |
|---|---|---|---|
| prawdziwe (80) | 80 | 0 | 0 |
| podmieniona wartość (80) | 12 | 67 | 1 |
| podmieniony rok (79) | 74 | 5 | 0 |
Podmienioną wartość złapał w 84% przypadków. Dwanaście „przepuszczonych” to prawie wyłącznie zakresy, które po podmianie nadal zachodzą na oryginał: cytat mówi „3–5 dni”, twierdzenie po podmianie „4–5 dni”; „2–4 tygodnie” vs „3–4 tygodnie”. Można się spierać, czy to jest sprzeczność. Jeden przypadek był czysty i wstydliwy dla modelu: „100–200 zł dziennie” w cytacie, „150–200 zł” w twierdzeniu, odpowiedź „wspiera” — ale z pewnością 0,28, czyli dokładnie tam, gdzie próg 0,8 wysłałby to do człowieka.
Podmienionego roku nie zauważył w 74 przypadkach na 79. I to nie jest bug, tylko udokumentowana cecha: TypeSafe pisze wprost, że JEV „czyta daty jako tekst, nie jako uporządkowane wielkości” i nie liczy. Porównanie roku z cytatem to robota dla regexa, nie dla modelu. Kod liczy, JEV osądza.
W praktyce ten test daje mi bramkę, której brakowało w pisaniu treści: każda liczba w drafcie dostaje pytanie relation wobec cytatu z pliku faktów, a przy pewności poniżej 0,8 leci do sprawdzenia ręcznego. Nie zastępuje to przeczytania źródła przed publikacją — ale odsiewa 80% roboty i wyłapuje sprzeczności, których człowiek w trzydziestej tabeli już nie widzi.
Test 4: audyt cytowalności własnych stron — i saga o ekstrakcji
Tu miało być prosto: dla 106 własnych stron ocenić lead (czy odpowiada od razu, czy jest samodzielny, czy ma dowód z pierwszej ręki, jak bardzo jest generyczny) i każdą sekcję H2 (czy nagłówek jest pytaniem, czy pierwsze zdanie odpowiada, czy sekcja to treść czy autopromocja). Pytania inspirowane rubryką Stephena Sumnera (odpowiedź w pierwszym akapicie do 80 słów) i regułą pełnej samodzielności fragmentu.
Sekcje H2: 832 sekcje, jeden wynik, którego się spodziewałem
| Typ strony | Sekcji H2 | Nagłówek jest pytaniem | Odpowiedź w 1. zdaniu | Sekcja = autopromocja |
|---|---|---|---|---|
| słownik | 160 | 39% | 58% | 9% |
| blog | 240 | 40% | 42% | 20% |
| Akademia SEO | 40 | 45% | 57% | 28% |
| artykuły | 64 | 34% | 38% | 28% |
| strony miejskie (agencja) | 96 | 15% | 20% | 38% |
| case studies | 48 | 23% | 38% | 48% |
| strony usługowe | 184 | 4% | 18% | 40% |
| razem | 832 | 28% | 37% | 27% |
Przykłady nagłówków, które JEV oznaczył jako promo z pewnością ≥0,85: „Chcesz realnego wzrostu?”, „A wiesz, że…”, „Mówimy o marketingu”, „Double or nothing”. Ma rację. Na stronach usługowych cztery na dziesięć sekcji H2 mówi o nas, nie odpowiada klientowi — i żaden dotychczasowy audyt tego nie policzył, bo nikt nie chciał ręcznie czytać 184 sekcji.
Koszt tej części: 897 wywołań, $0,034.
Leady: trzy podejścia, trzy różne porażki
I tu zaczyna się najciekawsza część artykułu, choć nie ta, którą planowałem.
Podejście 1. Wziąłem markdown po pruningu Crawl4AI i pierwsze 220 słów podałem jako lead. Wynik: 48 stron, każda z cytowalnością 0,01–0,13 i oceną „generyczna”. Spójnie, jednoznacznie, całkowicie fałszywie — bo na górze każdej strony stoi baner zgody na cookies i to jego JEV ocenił jako wstęp artykułu. Model nie powiedział „to nie jest lead”. Ocenił baner cookie jako lead i dał mu 0,05 na 2. Gdybym nie otworzył jednego pliku, miałbym gotowy raport, że cała moja strona jest niecytowalna.
Podejście 2. Wziąłem akapit bezpośrednio przed pierwszym H2. Dla bloga i słownika zadziałało (i dało wyniki, które cytuję niżej), ale strony usługowe dostały jako „lead” etykietę z menu: „SEO + AI Search”. Trzy słowa. Dodałem pytanie kontrolne „czy to jest proza wstępna, czy nawigacja?” — i JEV w 30 przypadkach na 48 uznał te trzy słowa za prozę wstępną. Nie odrzuca zbyt krótkiego wejścia. Bramka długości musi być w kodzie.
Podejście 3. Pobrałem surowy markdown, znalazłem prawdziwy H1 i wziąłem tekst pod nim. Strony usługowe i miejskie nareszcie dostały swój hero („Prowadzimy kampanie Google Ads w Radomiu dla firm, które rozliczają budżet z wyniku, nie z kliknięć. Średni ROAS 1066%…”) — 29 stron, 100% z odpowiedzią od razu, mediana cytowalności 1,88 na 2. Ale w słowniku pod H1 stoi biogram autora, a w blogu pasek „Czytaj nas częściej w Google — dodaj Double Digital jako preferowane źródło”. JEV ocenił biogramy jako leady definicji (mediana 0,10 na 2). Znowu spójnie i fałszywie.
Podejście 4, ostatnie. Kazałem JEV pilnować JEV-a: dla każdego kandydata na lead pytanie „czym jest ten akapit: proza wstępna / boilerplate / biogram / metadane?”, bierzemy pierwszy akapit uznany za prozę z pewnością ≥0,6. Bramka odrzuciła 110 kandydatów (92 jako boilerplate — w tym wszystkie spisy treści — i 18 biogramów). To zadziałało w większości przypadków. Ale pasek „Czytaj nas częściej w Google…” raz dostawał 0,11 jako proza, a innym razem przechodził. Ten sam tekst, różny tytuł strony w kontekście — różna decyzja.
Co z tego wynika, bo to jest ważniejsze niż tabelka z wynikami:
- JEV ocenia to, co dostał, i nigdy nie mówi „to nie jest to, o co pytasz”. Każde pytanie zakłada, że wejście ma sens. Sprawdzenie, czy ma sens, to osobna robota: długość, struktura, pozycja w dokumencie — kod; „proza czy śmieć” — może być JEV, ale z własnym progiem i własną kalibracją.
- Ekstrakcja jest trudniejsza niż osąd. Trzy różne szablony stron w jednym serwisie, trzy różne miejsca, w których stoi lead. Do audytu własnych stron lepiej brać treść z CMS-a (REST, pola) niż ze scrape’u. Do stron cudzych trzeba bramki.
- Spójny wynik nie znaczy poprawny wynik. 48 stron z oceną 0,01 wyglądało jak silny sygnał. Było artefaktem.
Wyniki leadów, którym ufam (tylko strony, na których ręcznie sprawdziłem, że model dostał właściwy fragment):
| Typ strony | Stron | Odpowiedź od razu | Cytowalność (mediana, 0–2) | Dowód z pierwszej ręki |
|---|---|---|---|---|
| słownik (definicje) | 8 | 100% | 1,98 | 0% |
| strony usługowe i miejskie (hero) | 29 | 100% | 1,88 | 88–100% (hero podaje ROAS z projektów) |
| blog | 8 | 38% | 1,41 | 0% |
Najsłabsze leady bloga to klasyczne chrząkanie: „Walka o klienta staje się coraz cięższa…” (0,18), „Na rynku jest wiele firm, które oferują marketing automation…” (0,58). Najlepsze — definicje słownikowe: „Quality Score to wskaźnik diagnostyczny Google Ads, oceniany w skali od 1 do 10…” (1,97). To nasze strony, model ma rację i mamy co poprawiać.
Test 5: analiza konkurencji z top10 — po co JEV w pipeline briefu
Ten test zrobiłem jako pierwszy i był pretekstem do wszystkich pozostałych. W naszym procesie tworzenia briefu treści crawlujemy strony z top10, przepuszczamy je przez pruning Crawl4AI (odsiew nawigacji po gęstości tekstu i linków), a potem model natywny czyta wycinki i buduje macierz pokrycia atrybutów. Problem: pruning z progiem 0,45 zostawia na stronach usługowych sporo śmieci. Na jednej ze stron konkurenta 19% słów po pruningu siedziało w sekcjach promocyjnych i nawigacyjnych (feed YouTube na górze, cztery bloki „umów bezpłatną rozmowę”, „Related Posts”, biogram).
Co JEV zrobił na 5 stronach konkurentów (73 sekcje):
- Rola sekcji (merytoryczna / promo / nawigacja / autor): 68% etykiet z pewnością ≥0,85 — i wszystkie te pewne etykiety zgodne z moją ręczną oceną. Rozbieżności (4) miały pewność 0,58–0,80, czyli dokładnie w paśmie „do przeglądu”.
- Typ strony z treści, nie ze sluga: forum, landing, artykuł rozpoznane poprawnie — z jednym wyjątkiem, który potwierdza regułę: pierwsze 700 słów strony digad.pl dało „landing usługowy” (bo to feed YouTube i CTA), cała strona dała „artykuł” (0,83).
- Macierz pokrycia: 10 atrybutów tematu („koszt Google Ads”, „wizytówka Google”, „opinie”, „mierzenie skuteczności”…) × 5 stron, pytanie tak/nie per sekcja, maksimum per strona. 51 wywołań, $0,004, wynik zgodny z tym, co jest na stronach. To jest tabela, którą do tej pory wypełniał model natywny z wycinków, z zastrzeżeniem „brak w wycinku nie znaczy brak na stronie”.
- Rola encji (Google Ads, wizytówka Google, hasła reklamowe, TikTok, autor…) oceniana na skali 0–3 per sekcja i agregowana w kodzie. Tu wyszła kolejna udokumentowana słabość: ocena całej strony naraz zaniżała (SEO: 1,84 na całej stronie vs 2,99 w najlepszej sekcji), bo — cytując dokumentację — „treść niezwiązana z decyzją działa jak rozpraszacz”. Per sekcja i agregacja w kodzie, zawsze.
Dlaczego to ma znaczenie dla polskiego SEO: Google Natural Language API, na którym opiera się większość poradników o „entity salience”, nie obsługuje polskiego w analizie encji. spaCy z polskim modelem na tej samej stronie zwrócił 29 razy „Google”, miasta i marki aut — zero encji pojęciowych typu „wizytówka Google” czy „hasła reklamowe”. JEV z listą kandydatów podaną przez model natywny jest dziś najtańszym sposobem, żeby na polskiej stronie policzyć, które pojęcia niosą treść, a które są wzmianką — nie w skali Google’a, ale w skali, którą da się skalibrować.
Gdzie JEV zawodzi — pięć pułapek, każda zmierzona
1. Nie zna świata. Bez kontekstu zapytanie „double digital” nie było dla niego marką (0,54), a „pozycjonowanie stalowa wola” było (0,86). Dodałem do wejścia dwie linijki: opis naszej firmy i podpowiedź, że Stalowa Wola to miasto. Wynik: 0,96 i 0,06. Gazetteer marek i miast to robota dla kodu; JEV dostaje go jako dane, nie jako założenie.
2. Nie liczy i nie porównuje dat. Podmieniony rok: 74 przepuszczone na 79. Częstości, długości, daty, TF-IDF — kod.
3. Nie odrzuca śmiecia. Baner cookie jako lead, „SEO + AI Search” jako proza. Bramki w kodzie przed pytaniem.
4. Czyta dosłownie i traci przy nakładających się kategoriach. Pole „usługa” z 50% zgodności z LLM-ami, bo moje opisy się nakładały. Kategorie rozłączne albo pytania hierarchiczne.
5. Pewność to nie trafność. confidence mierzy, jak skupiony jest rozkład, nie czy odpowiedź jest dobra. Benchmark OpenRouter na 3 080 wypowiedziach Banking77 (77 klas) pokazuje to wprost: przy pewności ≥0,99 JEV ma 96% trafności, przy pewności <0,5 — 30%. W całości 81,0% wobec 84,4% dla Claude Opus 5, 13 razy szybciej i za 1/22 ceny. Niezależny benchmark jev-frontier-bench (200 decyzji, 6 modeli) daje 72,5% wobec 84,0% dla Claude Fable 5.1 — z najlepszym wynikiem JEV w pytaniach tak/nie (94%) i najgorszym w ocenach na skali 1–5 (62%). Z tego wynika prosta reguła: Noul i trzypoziomowy Score tak, pięciogwiazdkowe ratingi nie.
I jedna pułapka, której nie zmierzyłem, ale którą dokumentuje sam producent: JEV nie traktuje treści w state jako potencjalnie wrogiej. Crawlowana strona konkurenta, komentarz z forum, odpowiedź AI — wszystko to może zawierać instrukcje, które przesuną odpowiedź. Do takich danych dokłada się osobne pytanie o wstrzyknięcie (w cookbooku TypeSafe próg 0,7) i nigdy nie podaje własnych instrukcji obok obcego tekstu.
Jak to wpiąć w pracę: dziesięć reguł
Wszystkie wynikają z testów powyżej albo z dokumentacji TypeSafe, która — muszę to przyznać — jest uczciwsza niż większość materiałów o narzędziach AI (ma osobną stronę „jaggedness” o tym, czego model nie umie).
- Świat w state. Marki, ludzie, miasta, Twoje usługi — jako pola wejścia.
- Bramki deterministyczne przed pytaniem. Minimalna długość, obecność H1, udział słów „cookie”, regex liczb.
- Jeden element, jedno wywołanie, wiele pytań naraz. State per sekcja/fraza/para. Cała strona w jednym state zaniża.
- Pytania atomowe, zawsze z opcją „żadne z powyższych”, oba bieguny tak/nie opisane, poziomy skali od najgorszego. Jedno szerokie pytanie „czy to phishing?” dało w cudzym, prerejestrowanym teście 62,6%; pięć atomowych złożonych regresją logistyczną — 95% (beri.net, wrzesień 2026). Tam też: złe opisy kryteriów dały 16,7%, poniżej losowego 25%.
- Progi z etykiet, nie z dokumentacji. 100–200 ręcznych etykiet per pytanie, precision/recall na kilku progach, trzy pasma: automat / przegląd / odrzuć.
- Zapisuj surowe prawdopodobieństwa. Progi stroi się później bez ponownych wywołań.
- SERP i Search Console są sędziami. JEV jest drugą opinią; rozbieżność z embeddingiem to lista do sprawdzenia, nie decyzja.
- Pinuj wersję modelu i wersjonuj treść kryteriów jak kod.
- Obca treść w state = ryzyko wstrzyknięcia.
- Kompozycja w kodzie. Wynik „gotowości na AI” to ważona suma odpowiedzi na atomowe pytania z jawnymi wagami, nie jedno pytanie „czy strona jest gotowa”.
Minimalne wywołanie, od którego zaczynałem (Python, requests):
import requests

resp = requests.post(
    "https://openrouter.ai/api/alpha/decisions",
    headers={"Authorization": f"Bearer {OPENROUTER_API_KEY}"},
    json={
        "model": "typesafe/jev-1.13",
        "state": {
            "our_brand": "Double Digital — agencja SEO i Google Ads z Krakowa",
            "query": "pozycjonowanie stalowa wola",
        },
        "questions": {
            "intent": {
                "type": "choice",
                "instructions": "Dominująca intencja zapytania `query`.",
                "criteria": {
                    "informacyjna": "Chce zrozumieć pojęcie lub proces",
                    "komercyjna": "Porównuje oferty, szuka wykonawcy, cen, rankingu",
                    "nawigacyjna": "Chce trafić na konkretną stronę",
                    "none": "Nie da się ocenić",
                },
            },
            "brand": {
                "type": "noul",
                "instructions": "Czy `query` zawiera nazwę firmy lub narzędzia jako podmiot wyszukiwania? Miasto to nie marka.",
                "criteria": {"true": "Tak, nazwa własna firmy/narzędzia", "false": "Nie, zapytanie generyczne"},
            },
        },
    },
    timeout=60,
)
answers = resp.json()["answers"]
# answers["intent"]["choice"], answers["intent"]["confidence"], answers["brand"]["noul"]
Cztery linijki logiki, reszta to definicja pytań. I to jest dokładnie ta część, którą trzeba pisać jak kod, testować jak kod i wersjonować jak kod.
Co z tego zostaje w mojej pracy
Nie wszystko, co wyszło w testach, wchodzi do produkcji. Kolejność, którą przyjąłem, od najtańszego wdrożenia:
- Etykiety dla fraz z Search Console (intencja, usługa, szablon, lejek, „pytanie do AI”) jako warstwa w cotygodniowym raporcie kandydatów do optymalizacji. 12,6 tysiąca fraz to niecały dolar.
- Bramka jakości SERP w walidatorze klastrów — już działa. NodesHub co kilka procent zapytań zwraca wyniki dla części frazy („seo lublin” → Wikipedia o Lublinie); JEV złapał 4 na 4 takie śmieciowe SERP-y bez fałszywych alarmów, gdzie heurystyka słów kluczowych dawała 8 fałszywych na 12.
- Bramka faktów w pisaniu treści: każda liczba w drafcie vs cytat, pewność <0,8 do człowieka.
- Audyt sekcji H2 na wszystkich stronach usługowych — z ekstrakcją z CMS-a, nie ze scrape’u, po tym, co widziałeś wyżej.
- Klasyfikacja odpowiedzi AI (czy wyszukiwanie się aktywowało, czy jesteśmy cytowani, czy odpowiedź jest zgodna z naszym cennikiem) — jak tylko będzie zbieracz odpowiedzi; sam klasyfikator to te same pytania co w teście 3.
Czego nie wdrażam: JEV jako zamiennika embeddingów w klasteryzacji (lepsza hipoteza, nie tańsza walidacja), JEV jako oceniacza „czy ta strona zasługuje na cytowanie” (osąd holistyczny — rozbić na atomy albo zostawić modelowi natywnemu), JEV do czegokolwiek z datami.
I jedno ostrzeżenie na koniec, którego brakuje w każdym tekście o tym modelu, jaki czytałem: to jest zamknięty model jednego dostawcy, na OpenRouterze od tygodnia. Interfejs trzymam w jednym module, żeby dało się go podmienić na tani LLM ze structured output, gdyby TypeSafe zniknął. Na razie nie muszę — ale nie buduję na nim niczego, czego nie dałoby się przepiąć w jeden dzień.
FAQ
Czy JEV zastępuje ChatGPT / Claude w SEO?
Nie. Nie generuje tekstu, nie streszcza, nie pisze briefów. Zastępuje etykietowanie i osąd na dużej liczbie elementów: klasyfikację fraz, ocenę sekcji, porównanie par, sprawdzenie cytatu. Model językowy zostaje do syntezy i decyzji — ale dostaje dane już posortowane.
Czy działa po polsku?
W moich testach tak, na polskim tekście i z polskimi kryteriami, bez widocznej różnicy jakości. TypeSafe nie deklaruje oficjalnie listy języków, a wszystkie publiczne benchmarki są po angielsku — więc to obserwacja z ~3 000 wywołań na moich danych, nie gwarancja.
Ile to kosztuje w praktyce?
400 fraz z siedmioma pytaniami: $0,026. 832 sekcje H2 z czterema pytaniami: $0,034. 160 par twierdzenie–cytat: $0,005. Cały ten artykuł to około 20 centów po stronie JEV. Dla porównania te same 120 fraz w Claude Haiku 4.5 kosztowały 11 centów, w GPT-4.1 mini 3,4 centa.
Czy JEV poprawia klasteryzację słów kluczowych?
Jako drugą opinię — tak: wyłapał błędy embeddingów (frazy wciśnięte do klastra sąsiedniego miasta, „ile kosztuje seo” w klastrze rankingów) i uczciwie oznaczył niejednoznaczne. Jako sędziego — nie; sędzią zostaje SERP, a JEV nie zna formatu wyników Google.
Czy mogę mu zaufać przy sprawdzaniu faktów?
Przy sprawdzaniu, czy cytat mówi o tej samej wartości — w moich testach tak (0 fałszywych „wspiera” na 150 kontrolach, 84% wykrytych podmian liczby). Przy okresach, datach i arytmetyce — nie; to sprawdzaj kodem. I nadal czytaj źródło przed publikacją; JEV odsiewa, nie zwalnia.
Od czego zacząć?
Od jednego pytania na 100–200 elementach, które już masz oetykietowane ręcznie (frazy z intencją, sekcje z oceną, pary fraz z werdyktem). Policz, przy jakim progu zgadza się z Tobą wystarczająco często. Dopiero potem automatyzuj — i tylko w paśmie wysokiej pewności.